DeepSeek vừa ra mắt V4.1 Flash, model nhỏ nhất trong dòng kiến trúc mới của hãng, với khả năng hiểu hình ảnh gốc và cửa sổ ngữ cảnh một triệu token. Đây không phải bản nâng cấp thông thường: V4.1 Flash dùng kiến trúc hoàn toàn khác so với các model trước, và theo các benchmark DeepSeek công bố, nó vượt model Pro tiền nhiệm trên phần lớn tác vụ agent.
Kiến trúc trúc mới với nâng cấp
DeepSeek V4.1 Flash sở hữu tổng cộng 552 tỷ tham số nhưng lại vận hành dựa trên kiến trúc Causal Encoder-Decoder (CED) hoàn toàn mới, khác biệt so với khối Transformer truyền thống. Nhờ cấu trúc chia tách gồm 20 lớp encoder và 20 lớp decoder, trong đó bộ nhớ KV cache toàn cục của decoder được chiếu trực tiếp từ trạng thái ẩn cuối của encoder, model đạt mức tối ưu ấn tượng: chỉ kích hoạt 8 tỷ tham số ở bước xử lý đầu vào (input) và 16 tỷ tham số khi khởi tạo đầu ra (output).
Sự cắt giảm tham số hoạt động này mang lại giá trị thực tiễn rất lớn. Trong các hệ thống agent, phần lớn tài nguyên tính toán bị tiêu tốn ở giai đoạn prefill (đọc context dài, xử lý dữ liệu hình ảnh, gọi tool). Việc đưa số lượng tham số active khi prefill xuống còn 8 tỷ thay vì 49 tỷ như ở bản V4 Pro, giúp tối ưu hóa và giảm đáng kể chi phí vận hành khi xử lý lượng input lớn.
Tối ưu hóa bộ nhớ KV cache là cải tiến trọng tâm được DeepSeek nhấn mạnh nhất. Cụ thể, dung lượng global KV cache của V4.1 Flash được tinh giảm xuống còn 890 byte cho mỗi token, chỉ bằng một phần tư so với thế hệ V4 Flash. Khi vận hành kết hợp với cơ chế SWA Bounded Replay, lượng bộ nhớ KV cần duy trì cho lưu trữ dài hạn thậm chí giảm xuống chỉ còn 1/8 so với trước đây.
Cơ sở kỹ thuật cho sự cắt giảm này nằm ở kiến trúc Compressed Sparse Attention 2 (CSA2), trong đó mỗi lớp attention được phân bổ cố định vào một trong ba chế độ tĩnh (Full, Reindex, hoặc Reuse) nhằm chia sẻ dữ liệu KV chính và tận dụng lại chỉ mục sparse attention. Giải pháp này kết hợp cùng công nghệ FP4 caching đã hạ thấp đáng kể chi phí lưu trữ cache. Dù vậy, các thông số này hiện mới chỉ dựa trên công bố từ phía DeepSeek và chưa qua kiểm chứng độc lập.
Do cache-hit chiếm tỷ trọng ngân sách rất lớn khi triển khai các hệ thống agent, việc nén dung lượng cache mang lại giá trị thực tế khi cắt giảm trực tiếp chi phí sử dụng API cho người dùng.
Vượt model Pro, giá rẻ hơn
Bảng kết quả benchmark được DeepSeek công bố trên Hugging Face ghi nhận những thành tích ấn tượng của V4.1-Flash (ở mức reasoning effort tối đa) trên hàng loạt tác vụ:
-
Terminal-Bench 2.1: Đạt 90,6%, vươn lên vượt qua Opus-5.0 (89,1%).
-
DeepSWE v1.1 (code agent): Đạt 74,2 điểm, ngang ngửa Opus-5.0 (74,0).
-
HLE (kèm công cụ): Dẫn đầu với 63,9 điểm, vượt Opus-5.0 (63,6).
-
Các benchmark agent & bảo mật khác: Chiếm vị trí cao nhất trên Codeforces (rating 3.471), CyberGym (88,1), AutomationBench (54,8) và Agent’s Last Exam (31,8).
Xét riêng ở các bài test suy luận thuần túy, V4.1 Flash vẫn xếp sau các dòng mô hình lớn như Opus 5 hay GPT-5.6 Sol ở một số tiêu chí (như GPQA Diamond đạt 90,9 so với 94,1; HLE đạt 36,8 so với 56,3). Dù vậy, với tư cách là một phiên bản dòng Flash vốn tối ưu cho chi phí và tốc độ, việc mô hình này theo kịp hoặc vượt qua các flagship ở mảng tác vụ agent là kết quả rất đáng ghi nhận.
Thay thế các model tiền nhiệm
Phiên bản V4.1-Flash hiện đã có mặt trên API DeepSeek với tên gọi deepseek-flash, hỗ trợ cả xử lý văn bản lẫn hình ảnh. Sự kiện này đánh dấu việc ngừng hoạt động của các model thế hệ trước là V4 Flash và V4 Flash Vision Exp, đồng thời kể từ ngày 14/9, các yêu cầu gửi đến mô hình V4 Pro cũng được tạm thời được điều hướng sang V4.1 Flash với mức phí tương ứng của model Flash này, cho đến khi V4.1-Pro ra mắt.
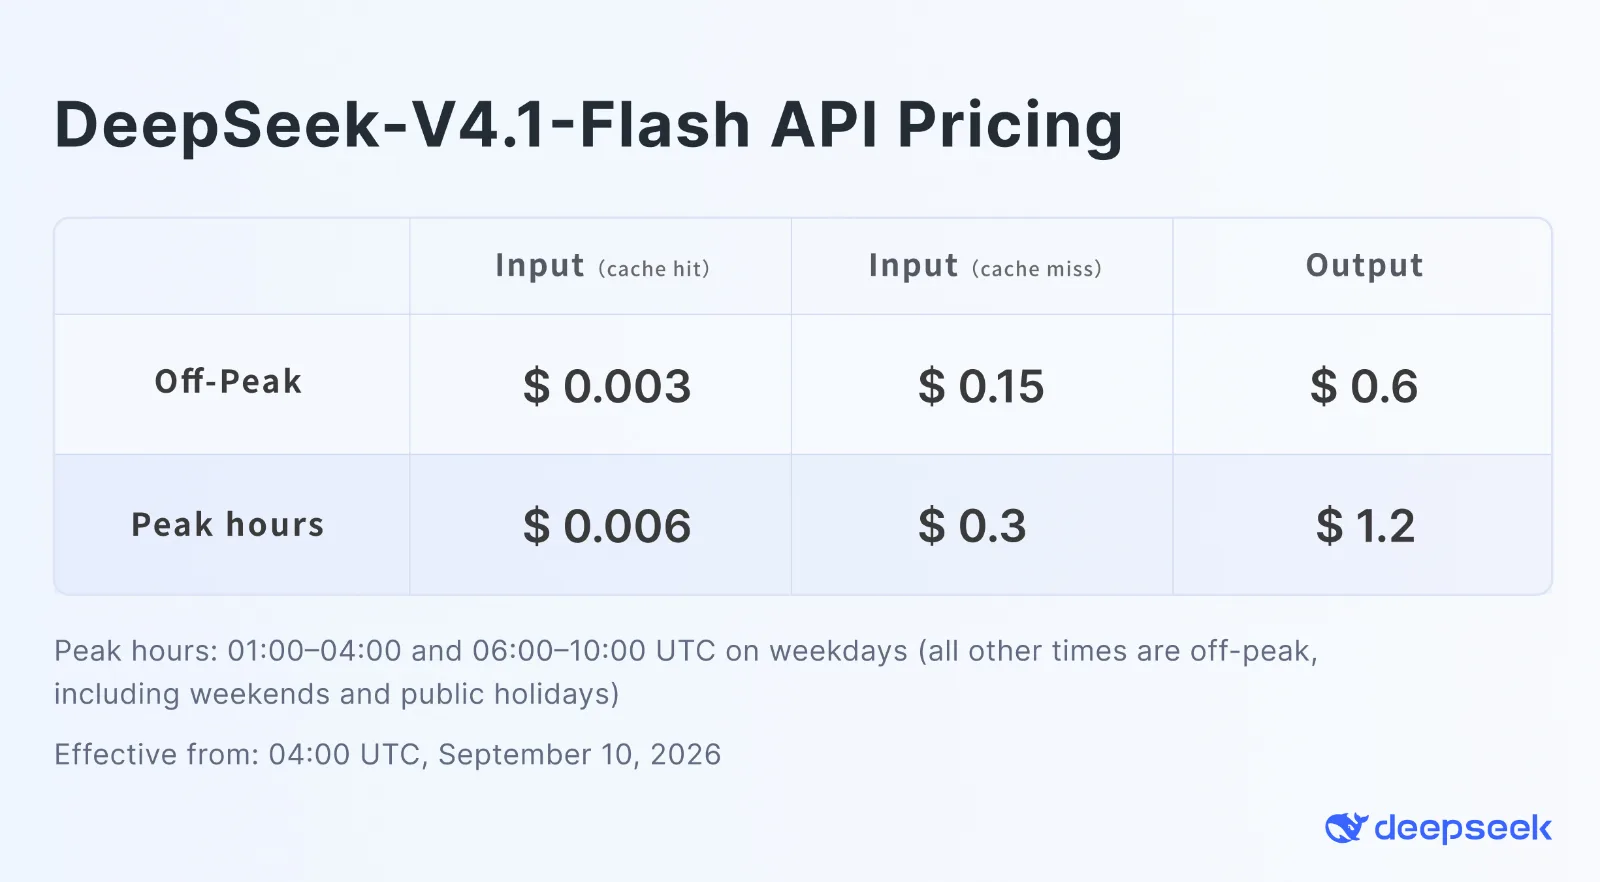
Về chính sách giá, bảng giá API mới bắt đầu có hiệu lực từ 04:00 UTC ngày 10/9, cung cấp mức ưu đãi giảm 50% cho khung giờ thấp điểm. Cụ thể:
- Giá off-peak: 0,153 USD/M input và 0,6 USD/M output.
- Giá peak hours: 0,306 USD/M input và 1,2 USD/M output.
DeepSeek cũng đã mở mã nguồn và công bố trọng số của model trên HuggingFace theo giấy phép MIT cùng báo cáo kỹ thuật chi tiết.
Nhìn tổng quan, V4.1 Flash cho thấy hướng đi khác biệt của DeepSeek khi không cuốn vào cuộc đua gia tăng tham số. Nhờ kiến trúc CED bất đối xứng giúp giảm tham số active khi prefill, hãng đạt được hiệu quả tối ưu chi phí mà vẫn đảm bảo chất lượng đầu ra. Việc trực tiếp thay thế model Pro bằng một model Flash trên API chứng minh chiến lược giảm giá bền vững bằng cải tiến kiến trúc thay vì chỉ giảm giá trên nền tảng cũ. Do mô hình được phát hành công khai trọng số, cộng đồng hoàn toàn có thể tự kiểm chứng qua các benchmark độc lập. Vấn đề then chốt tiếp theo là liệu phiên bản V4.1-Pro khi ra mắt có thể hiện được sự vượt trội rõ rệt so với bản Flash này hay không.