OpenAI bắt đầu thêm một dấu watermark vô hình vào văn bản do ChatGPT và Codex tạo ra tại khu vực Liên minh châu Âu nhằm tuân thủ quy định minh bạch của AI Act. Điểm đáng chú ý nhất trong thông cáo hôm 05/10 không phải cơ chế, mà là những con số công ty tự công bố về giới hạn của chính cơ chế đó.
Vì sao watermark văn bản khó hơn ảnh và âm thanh
Với ảnh và âm thanh, OpenAI đã công bố công cụ xác minh công khai và dấu SynthID vô hình được nhúng vào một số định dạng. Sang văn bản, bài toán khó hơn vì câu văn có thể bị chỉnh sửa, dịch lại hoặc viết lại gần như hoàn toàn mà vẫn giữ nguyên nghĩa.
Giải pháp của OpenAI có tên là textGrain. Thay vì chèn một ký hiệu, mô hình hơi nghiêng lựa chọn từ để tạo ra một mẫu thống kê mà người đọc không nhận ra nhưng bộ phát hiện có thể tìm thấy. Vì dấu nằm trong chính các từ, nó đi theo văn bản khi sao chép và dán. Công ty cho biết bí mật của phương pháp nằm ở một khóa dùng để sắp xếp dự đoán từ kế tiếp nhằm hoàn thành câu.
OpenAI nói textGrain đạt hoặc vượt các phương pháp họ thử, kể cả SynthID cho văn bản của Google. Đồng thời, công ty nói thẳng điều mà ít công ty trong ngành thường chịu nói: hiệu quả tốt trong điều kiện lý tưởng không bảo đảm phát hiện đáng tin cậy khi sử dụng thực tế.
Watermark dành cho chữ không thực sự hiệu quả
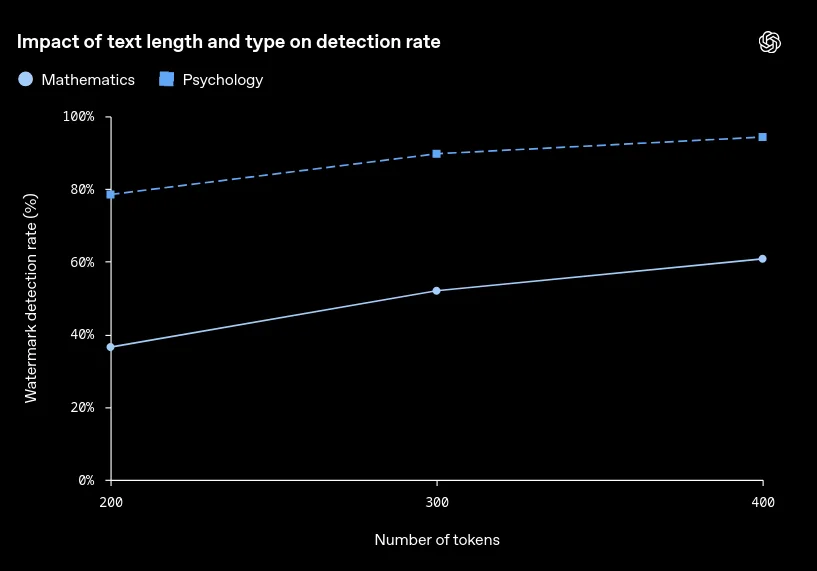
Bảng số liệu trong thông cáo vẽ ra rõ ranh giới của công nghệ hiện tại. Ở tỷ lệ báo nhầm dương tính 1%, bộ phát hiện tìm thấy dấu trong khoảng 80% đoạn 200 token, so với khoảng 95% đoạn 400 token với nội dung tâm lý học. Với nội dung toán học, nơi lựa chọn từ ít linh hoạt hơn, tỷ lệ thấp hơn đáng kể.
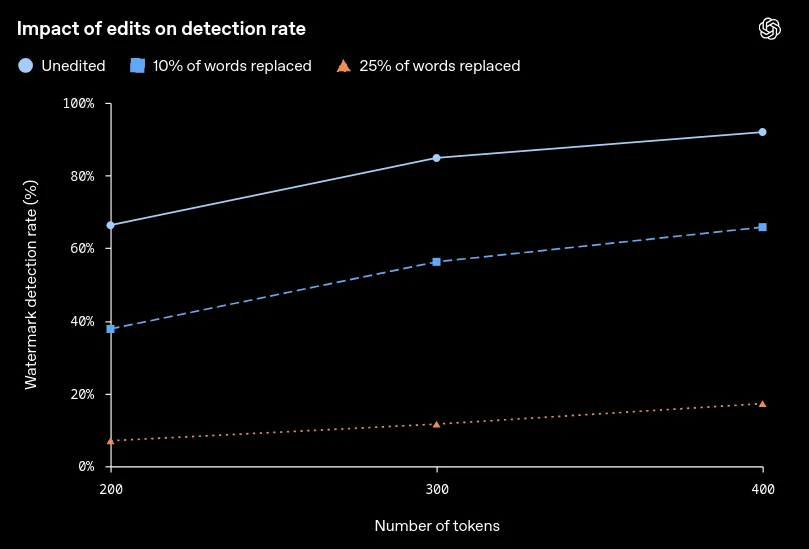
Hiệu quả còn nhạy với việc chỉnh sửa. Trên đoạn 400 token, thay 10% từ bằng từ đồng nghĩa khiến tỷ lệ phát hiện giảm từ khoảng 92% xuống 66%. Thay 25% từ, con số đó rơi xuống 17%.
Đó là lý do công ty không mở công cụ phát hiện cho công chúng ngay. Quyền truy cập ban đầu chỉ dành cho các nhà nghiên cứu và tổ chức chuyên môn được duyệt, xét từng trường hợp, nhằm đánh giá độ tin cậy trước khi mở rộng. Với hình ảnh và âm thanh, các công cụ xác minh vẫn mở công khai như trước.
Về phía triển khai, nhà phát triển dùng API trên toàn thế giới có thể chủ động bật watermark cho một số mô hình kể từ ngày 05/10, nhưng mặc định là tắt. Với người dùng ChatGPT và Codex, tính năng sẽ mở dần trong vài tuần tới, chỉ tại EU, áp dụng cho mọi gói. OpenAI nhấn mạnh họ không biến watermark thành mặc định toàn cầu lúc ra mắt, để có thời gian học từ phản hồi thực tế.
Watermark nói được điều gì và không nói được điều gì?
Đáng chú ý nhất trong thông cáo là phần định nghĩa riêng nhằm giới hạn phạm vi hiểu về kết quả phát hiện:
- Trước hết, watermark chỉ xác nhận một phần văn bản từng được hệ thống của OpenAI tạo hoặc xử lý, hoàn toàn không phản ánh mức độ đóng góp, sự sáng tạo hay công sức biên tập của con người. Dấu hiệu này cũng không quyết định bản quyền, quyền sở hữu hay tính hợp pháp khi sử dụng văn bản, đồng thời không liên kết với bất kỳ tài khoản, câu lệnh hay cuộc hội thoại cụ thể nào.
- Bên cạnh đó, việc không tìm thấy watermark không đồng nghĩa với việc văn bản được viết bởi con người. Đoạn văn có thể quá ngắn, đã qua chỉnh sửa sâu, hoặc do mô hình khác khởi tạo. OpenAI cũng cho biết dự định mở mã nguồn của phương pháp này trong tương lai.
Xét về bối cảnh, Anthropic trước đó hai tháng đã áp dụng đóng dấu văn bản Claude trên phạm vi toàn cầu, dẫn đến sự phản ứng từ một số người dùng, những người cho rằng họ mới là bên định hướng nội dung, còn Claude chỉ đóng vai trò công cụ. Dù vậy, Anthropic, Google, Meta, Microsoft và OpenAI đều cam kết tuân thủ quy tắc ứng xử của Liên minh châu Âu đối với nội dung do AI tạo ra.
Vấn đề cốt lõi vẫn còn bỏ ngỏ: liệu một giải pháp dễ mất hiệu lực chỉ sau khi thay đổi 25% số từ có đủ sức điều chỉnh hành vi người dùng, hay chỉ đóng vai trò như một lớp rào pháp lý cho các nền tảng trong khi niềm tin của người đọc vẫn chưa được thuyết phục.