Anthropic ra mắt Claude Opus 5.5, model đầu tiên trong dòng Claude 5.5 mới. Model đạt kết quả ngang hoặc vượt Claude Fable 5.1 trên hầu hết tác vụ, nhưng chi phí thấp hơn 40% so với Opus 5. Đây là model đầu tiên Anthropic phát hành sau lời kêu gọi “pacing the frontier” của CEO Dario Amodei, và đã được đánh giá bởi các tổ chức bên ngoài trước khi ra mắt.
Benchmark dẫn đầu ở coding và knowledge work
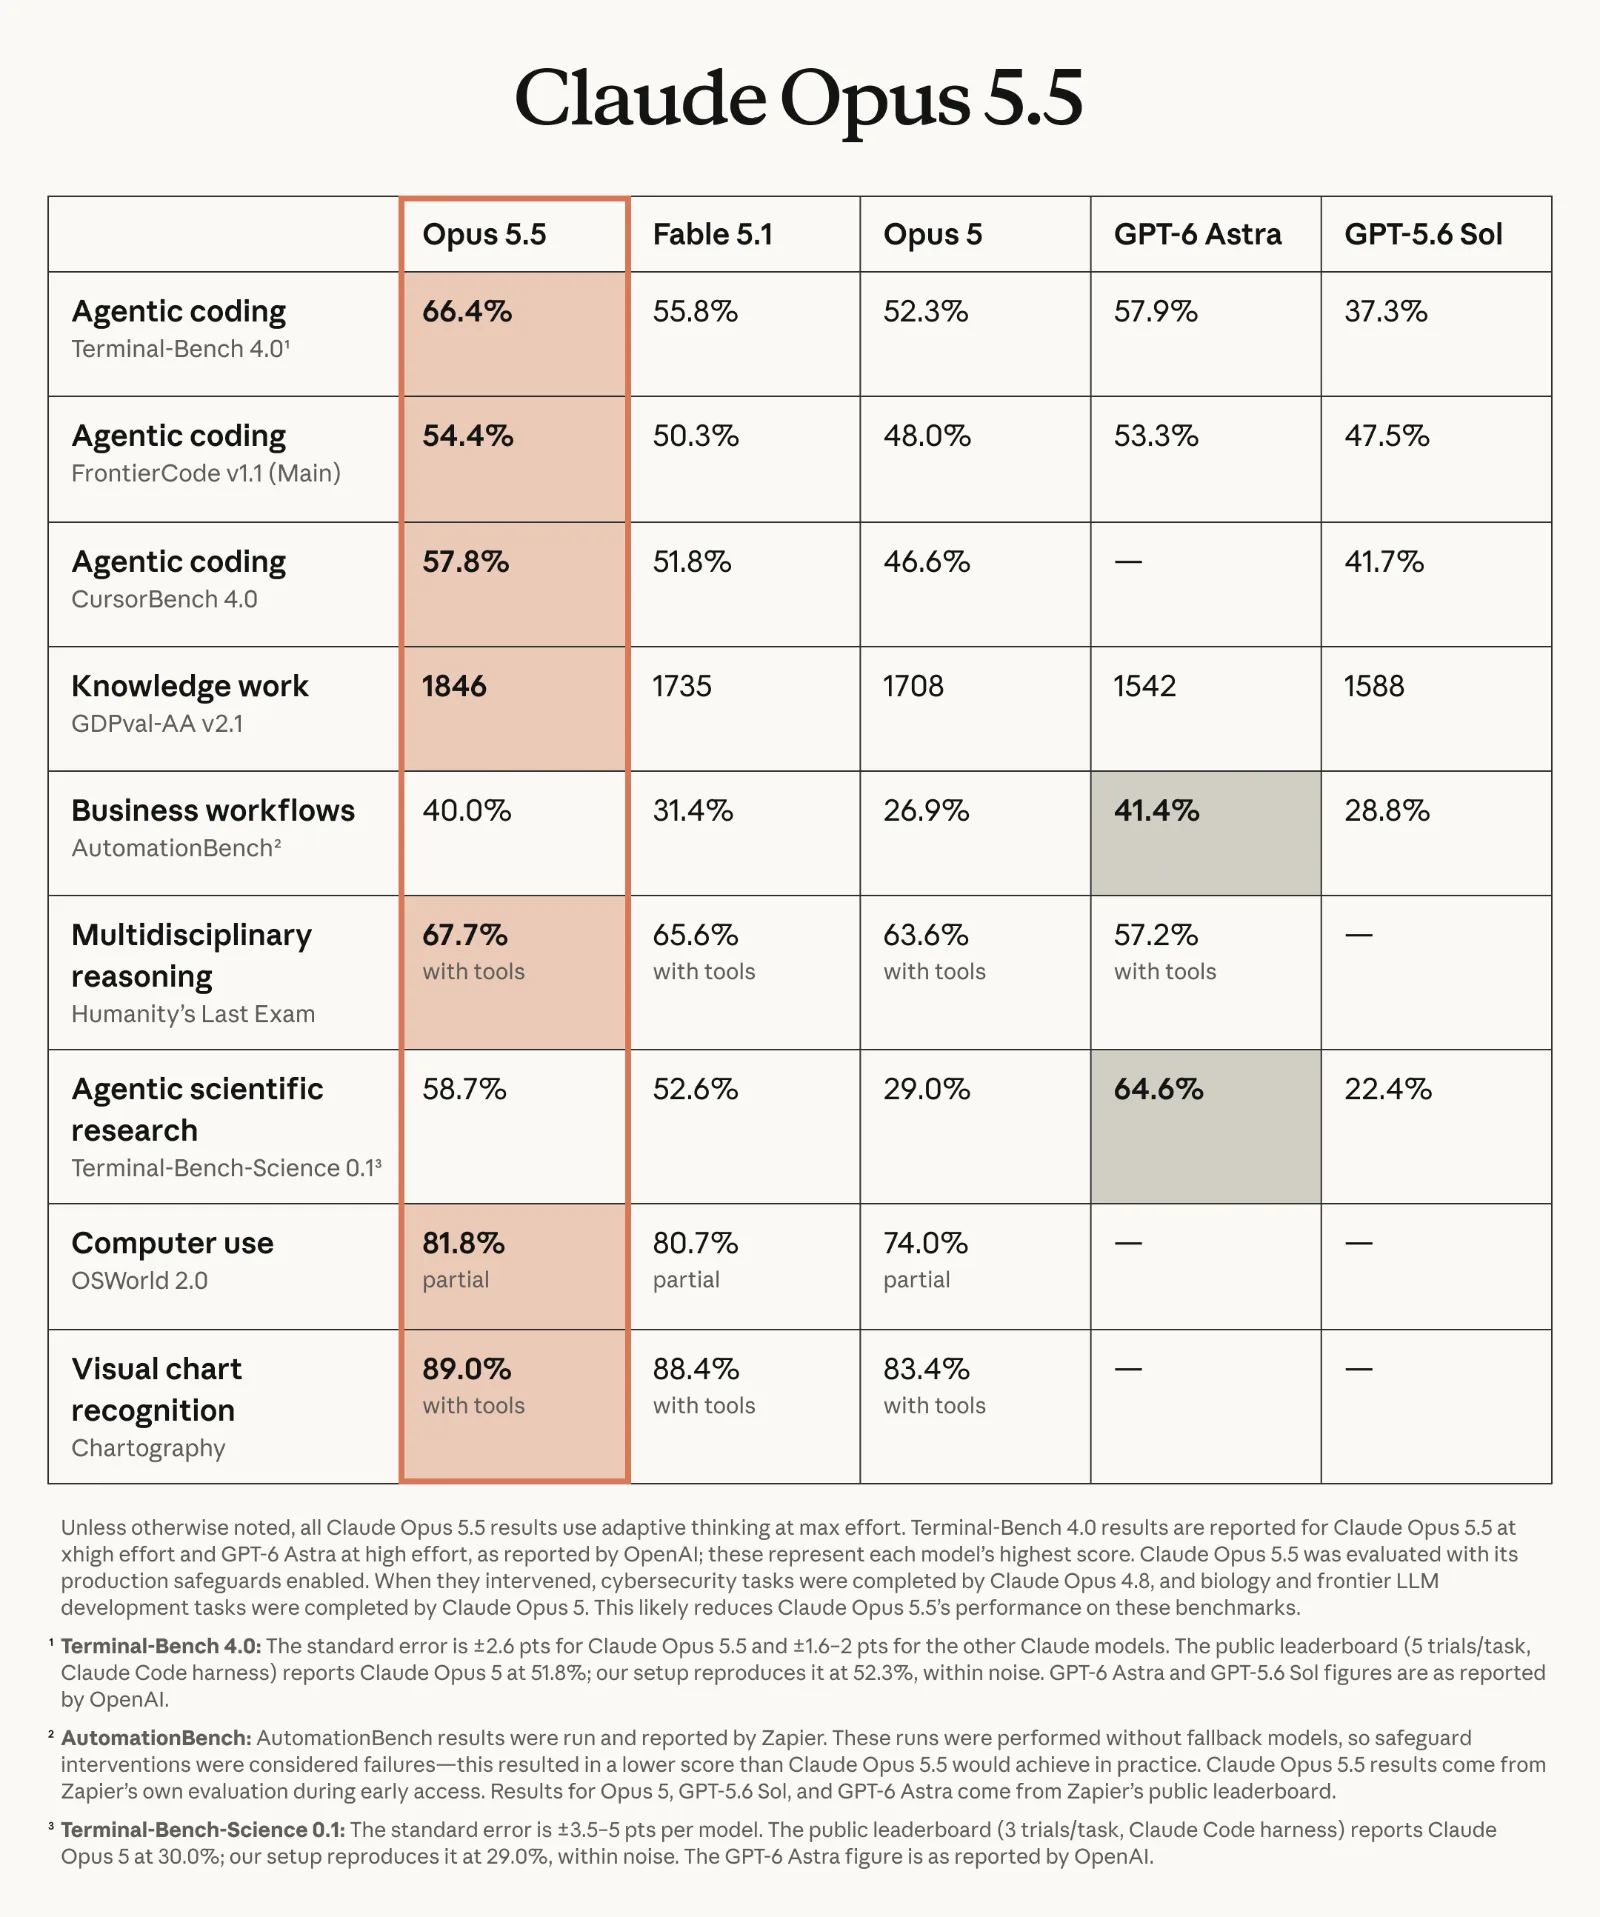
Theo benchmark do Anthropic công bố, Opus 5.5 dẫn đầu ở nhiều tác vụ quan trọng:
-
Terminal-Bench 4.0 (coding agent): Opus 5.5 đạt 66,4%, vượt Fable 5.1 (55,8%) và GPT-6 Astra (57,9%).
-
CursorBench 4.0 (coding đa file): 57,8%, vượt Fable 5.1 (51,8%).
-
GDPval-AA v2.1 (công việc văn phòng chuyên nghiệp): 1.846 Elo, vượt Fable 5.1 (1.735).
-
Humanity’s Last Exam với công cụ: 67,7%, vượt Fable 5.1 (65,6%).
-
AutomationBench (workflow tự động), Opus 5.5 đạt 40,0%, vượt Fable 5.1 (31,4%) và ngang GPT-6 Astra (41,4%).
-
OSWorld 2.0 (computer use): 81,8%, vượt Fable 5.1 (80,7%).
Tuy đây là số liệu Anthropic tự công bố, nhưng đã có đánh giá bên ngoài từ Frontier Design và METR trước khi ra mắt.
Điểm đáng chú ý nhất nằm ở hiệu quả chi phí. Anthropic cho biết Opus 5.5 hoàn thành một cuộc di chuyển codebase 680.000 dòng trong chưa đầy một ngày, công việc mà một đội kỹ sư sẽ mất nhiều tuần. Trong test nội bộ, Opus 5.5 cắt thời gian tải trang thành công 39 trên 40 lần, trong khi Opus 5 chỉ cải thiện nhỏ và thay đổi hành vi ứng dụng.
Giá giảm mạnh, tốc độ tăng 30%
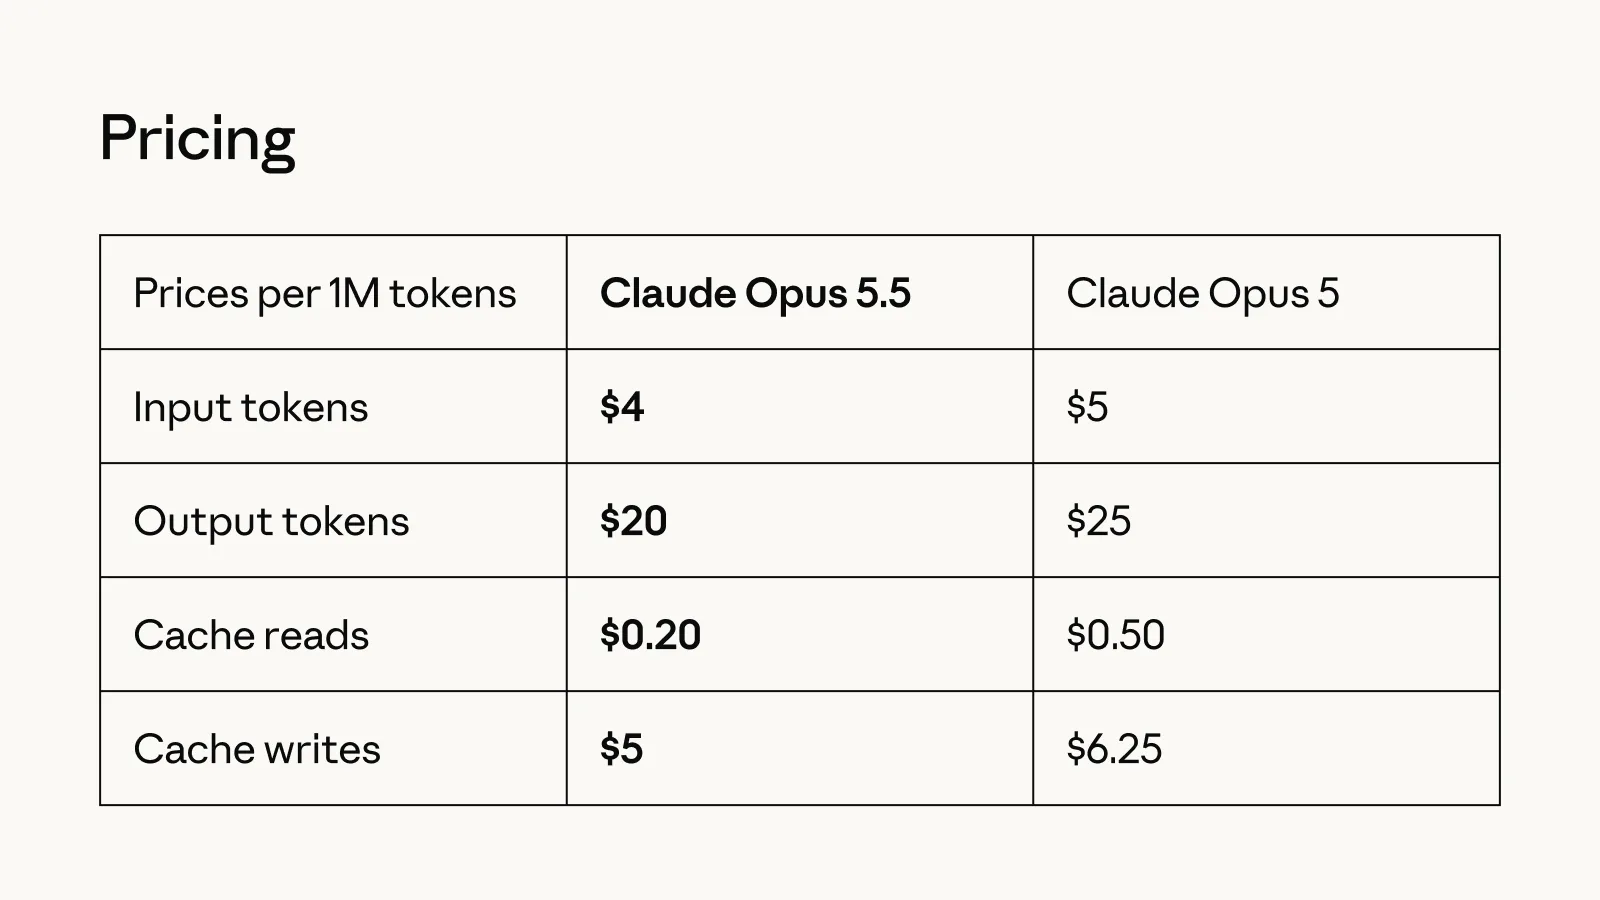
Opus 5.5 có giá 4 USD cho mỗi triệu token input và 20 USD cho mỗi triệu output, giảm lần lượt 20% và 25% so với Opus 5. Đáng chú ý nhất: cache reads chỉ 0,20 USD mỗi triệu token, giảm 60% so với Opus 5. Vì cache reads chiếm phần lớn chi phí trong coding và agent work, mức giảm này có tác động lớn hơn con số 20-25% trên input/output.
Opus 5.5 cũng sinh output nhanh hơn 30% so với Opus 5. Chế độ fast mode có sẵn trong Claude Code, nhanh gấp 2,5 lần với giá 8 USD input và 40 USD output.
Anthropic cũng tăng giới hạn sử dụng năm giờ cho các gói Pro, Max, Team và Enterprise, và cung cấp cho người đăng ký một lần đặt lại giới hạn tốc độ có thể lưu và sử dụng bất cứ lúc nào.
An toàn: Điểm cao nhất trên automated behavioral audit
Opus 5.5 đạt điểm cao nhất từ trước đến nay trên automated behavioral audit, bộ kiểm tra alignment hàng nghìn kịch bản mô phỏng. Model ít có khả năng thực hiện hành động khó đảo ngược hoặc hành động ngoài ranh giới được đặt, và chống prompt injection tốt hơn Opus 5.
Về cybersecurity, Opus 5.5 có năng lực ngang Fable 5.1 nên được áp dụng bảo vệ tương tự. Người dùng có thể xác định và sửa lỗi code trong quy trình phát triển phần mềm thông thường, nhưng hầu hết tác vụ cybersecurity sẽ được chuyển sang Opus 4.8. Chương trình Cyber Verification sẽ sớm mở rộng để bao gồm Opus 5.5.
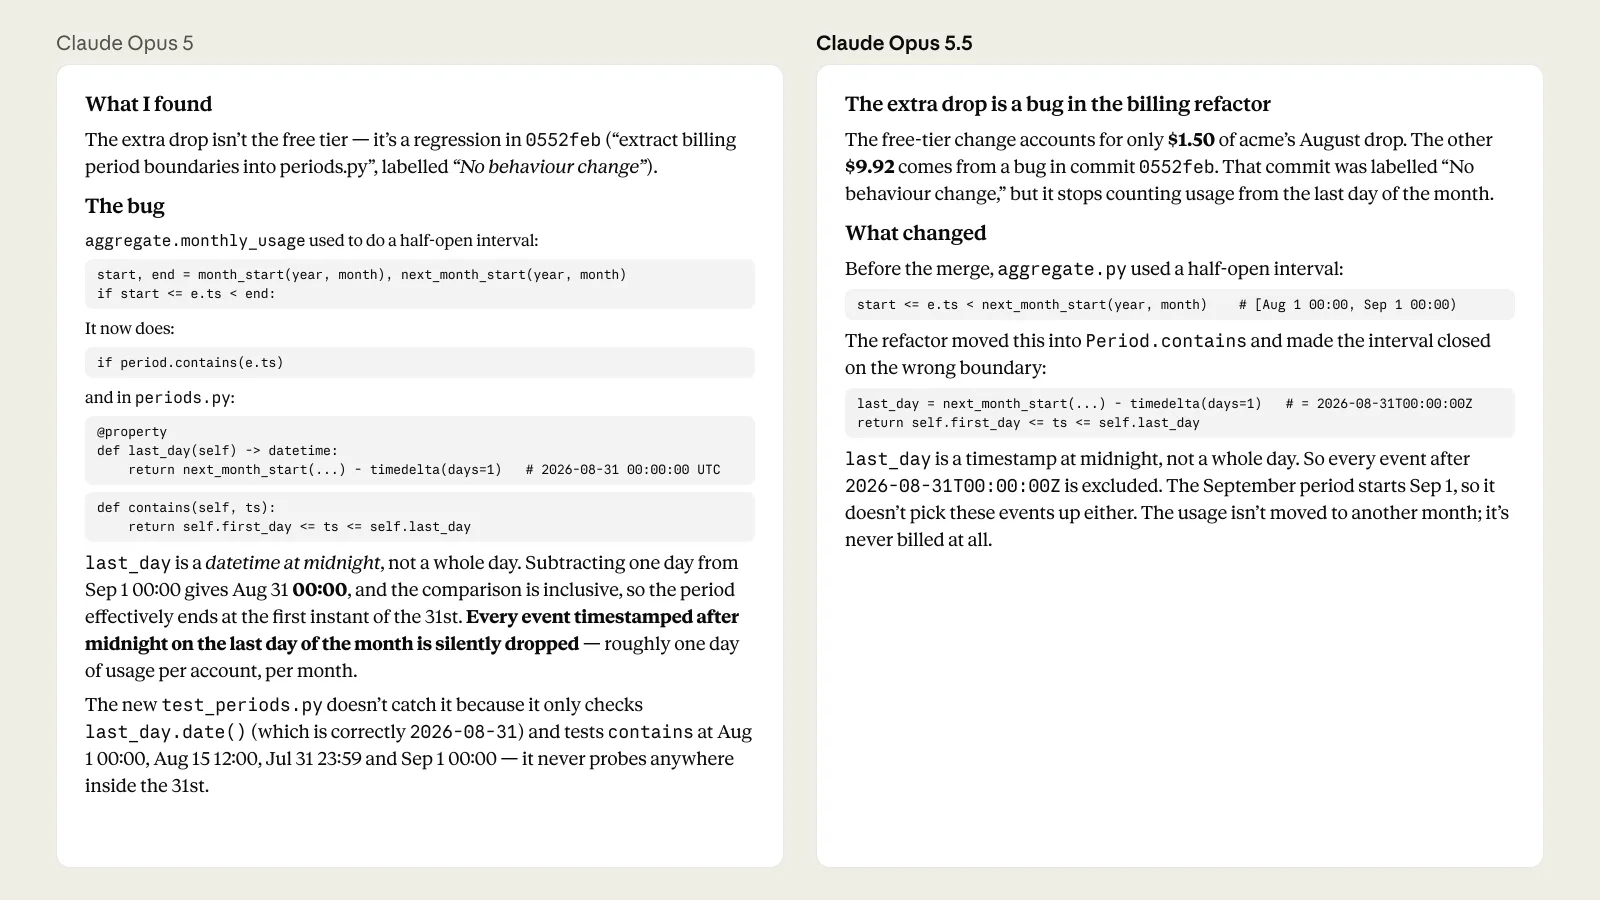
Về giao tiếp, Opus 5.5 được cho là giao tiếp tự nhiên hơn Opus 5. Nó đặt thông tin quan trọng nhất lên phía trước và tuân theo các quy tắc viết mà người dùng đưa ra, điều này làm cho các phiên học dài dễ dàng theo dõi hơn.
Về biology, Opus 5.5 đạt kết quả ngang hoặc vượt Claude Mythos 5.1. Chương trình Life Sciences Verification cho phép tổ chức đã được xác minh sử dụng Opus 5.5 cho nghiên cứu sinh học.
Opus 5.5 cũng ra mắt với preserved thinking, biện pháp chống distillation ngăn người dùng API chỉnh sửa ngữ cảnh trước đó của Claude để trích xuất reasoning.
Bối cảnh: cuộc đua giá AI đang diễn ra
Opus 5.5 ra mắt chỉ 90 phút trước khi OpenAI công bố GPT-6 Sol và Luna. Trong vòng 48 giờ, Grok 4.7 (SpaceXAI) ra mắt với giá 2/6 USD, Opus 5.5 với giá 4/20 USD, và GPT-6 Sol/Luna với giá 2/10 USD và 0,10/0,50 USD. Cấu trúc giá coordinated mà các lab đã giữ qua giai đoạn “pacing the frontier” đã sụp đổ trong chưa đầy hai ngày.
Sonnet 5.5 và Haiku 5.5 sẽ ra mắt trong những tuần tới, mang theo nhiều cải tiến tương tự về hiệu suất, hiệu quả và an toàn. Với người dùng, Opus 5.5 là lựa chọn mới đáng cân nhắc: năng lực ngang Fable 5.1 nhưng rẻ hơn nhiều, và đã được kiểm chứng bởi bên thứ ba trước khi ra mắt.