Ngày 29/09, OpenAI chính thức ra mắt GPT-6.1 Sol chỉ một tuần sau khi ra mắt GPT-6 Sol. Mô hình mới mang thông điệp cốt lõi: Mang lại hiệu năng gần tương đương GPT-6 Astra trong công việc chuyên môn, điều khiển máy tính và phát triển agent, nhưng giảm chi phí xuống chỉ còn 1/5. Yếu tố quyết định cho mức giá tối ưu này là việc hạ mạnh chi phí đọc ngữ cảnh lưu trữ, với giá token đầu vào từ bộ nhớ đệm giảm 95% so với chuẩn.
GPT-6.1 Sol được thiết kế để thay thế hoàn toàn phiên bản GPT-6 Sol tiền nhiệm chứ không đóng vai trò một phương án phụ. Quyết định phát hành model này diễn ra ngay sau khi OpenAI thông báo hủy bỏ bản mô hình cao cấp GPT-6.1 Astra do các sự cố liên quan đến quy chuẩn tuân thủ và quản trị rủi ro.
Giá API
Mức giá API cụ thể của GPT-6.1 Sol là:
-
Input: 2 USD/M token
-
Cached input: 0,10 USD/M token (Giảm 50% so với GPT-6 Sol và 95% so với GPT-6 Astra)
-
Output: 10 USD/M token
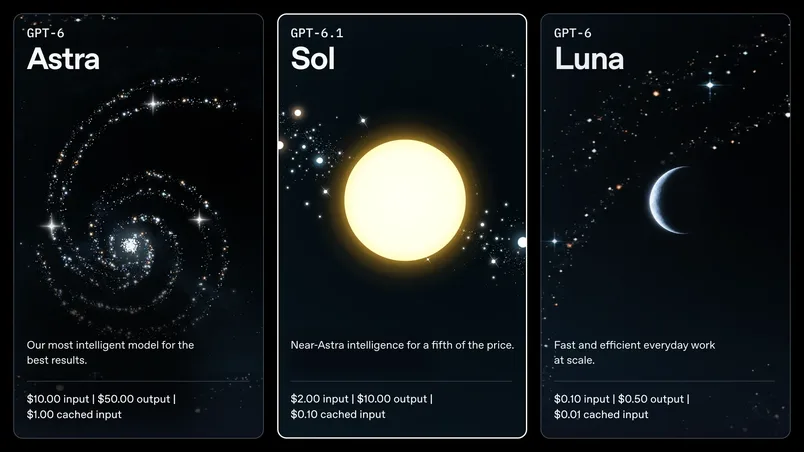
Mức giảm này mang lại hiệu quả kinh tế rõ rệt cho các agent thường xuyên tái sử dụng cùng một khối ngữ cảnh qua nhiều lượt tương tác. Ngược lại, đối với các tác vụ chatbot truy vấn một lần, mức chiết khấu này hầu như không làm thay đổi hóa đơn dịch vụ do không phát sinh việc đọc lại token từ cache.
Benchmark: Điểm số gần bằng GPT-6 Astra
Trong báo cáo về năm bài kiểm tra hiệu năng, OpenAI khẳng định GPT-6.1 Sol đạt mức hiệu suất tương đương hoặc tiệm cận GPT-6 Astra trên ba thử nghiệm đầu tiên:
-
DeepSWE v1.1 (Phát triển phần mềm dài hạn): Đánh giá năng lực xử lý codebase thực tế. GPT-6.1 Sol vượt mốc 75% với mức chi phí dưới 1 USD cho mỗi tác vụ. So với mức xấp xỉ 74% và 4,40 USD của GPT-6 Astra, đây là điểm sáng hàng đầu thể hiện khả năng tối ưu chi phí gấp khoảng 5 lần mà vẫn giữ nguyên hoặc gia tăng hiệu quả.
-
GDP.pdf (Phân tích tài liệu chuyên sâu): Thử nghiệm khả năng giải đáp các thắc mắc phức tạp từ tệp PDF. Model vượt điểm số của Claude Opus 5.5 (kèm cơ chế dự phòng) trong khi giảm một nửa chi phí vận hành.
-
AutomationBench (Quy trình làm việc đa bước): Khảo sát năng lực thực thi tác vụ dạng agent. Với mức suy luận trung bình, mô hình nhỉnh hơn Opus 5.5 2,2 điểm phần trăm dù chi phí chỉ bằng khoảng một phần ba.
Tuy nhiên, kết quả có sự phân hóa rõ rệt ở hai bài kiểm tra còn lại:
-
OSWorld 2.0 (Thao tác trên ứng dụng máy tính): Ở cấu hình suy luận cao nhất, model cải thiện 7 điểm phần trăm so với GPT-6 Sol nhưng vẫn kém Astra 2,1 điểm phần trăm, mặc dù mức phí rẻ hơn gần 7 lần.
-
Terminal-Bench Science 0.1 (Nghiên cứu khoa học nâng cao): Dù đạt điểm số cao gấp đôi GPT-6 Sol, model vẫn xếp sau Astra (vốn giữ vị trí dẫn đầu với 68,1%). Chính OpenAI cũng khuyến nghị tiếp tục sử dụng Astra cho các bài toán nghiên cứu phức tạp nhất.
Đáng chú ý về mặt phương pháp luận, dữ liệu của OpenAI được ghi nhận trong môi trường nội bộ, trong khi điểm số đối thủ dựa trên báo cáo công khai. Đối với AutomationBench, hãng lưu ý rằng chi phí thực tế của Claude Fable 5.1 có thể cao hơn do chưa tính khoảng 40% tác vụ phát sinh chi phí dự phòng.
Báo cáo độc lập từ Artificial Analysis không chỉ xác nhận các chỉ số do OpenAI công bố mà còn làm rõ thêm một số khía cạnh đáng chú ý khác.
Xét trên thang đo Intelligence Index, GPT-6.1 Sol đạt mức tăng 4 điểm so với GPT-6 Sol và nhỉnh hơn GPT-5.6 Sol 5 điểm, qua đó thu hẹp khoảng cách với GPT-6 Astra xuống chỉ còn 1 điểm. Về khía cạnh kinh tế, chi phí cho mỗi tác vụ ở mức suy luận tối đa của model chỉ là 0,72 USD, rẻ hơn 31% so với GPT-6 Sol và chưa bằng một phần tư so với con số 3,26 USD của Astra.
Đối với bài kiểm tra Coding Agent Index, model chỉ thua Astra 2 điểm ở thiết lập suy luận cao nhất, nhưng lại vượt Astra 1 điểm ở mức suy luận cực cao (xhigh) với mức chi phí chưa tới 15%. Việc gia tăng lượng token đầu ra trên mọi mức suy luận giúp model tiếp tục mở rộng ranh giới về hiệu quả chi phí so với thế hệ trước.
Bên cạnh đó, Artificial Analysis chỉ ra hai điểm quan trọng mà OpenAI chưa đề cập:
-
Tối ưu chi phí hỗn hợp: Nhờ đợt giảm giá đọc bộ nhớ đệm tiếp theo (sau lần giảm 50% ở bản GPT-6 Sol), chi phí tổng thể của model giảm nhẹ so với bản tiền nhiệm.
-
Tăng lượng token đầu ra: Model tiêu tốn nhiều hơn khoảng 10 đến 30% output token so với GPT-6 Sol. Ở mức suy luận thấp và trung bình, mức tăng điểm trí tuệ đủ để bù đắp lượng token phát sinh; tuy nhiên, ở mức suy luận cao nhất, sự đánh đổi này không còn duy trì hiệu quả tối ưu theo token.
An toàn và khả dụng
Xét về yếu tố an toàn, OpenAI khẳng định mô hình mới có độ minh bạch cao hơn về giới hạn của bản thân, đồng thời tuân thủ các ràng buộc người dùng một cách đáng tin cậy hơn, xấp xỉ mức của Astra.
Trong bài kiểm tra khả năng cảnh báo người dùng khi công cụ tìm kiếm gặp sự cố, GPT-6.1 Sol không phản hồi trong 2,1% trường hợp thấp hơn đáng kể so với 4,9% ở GPT-6 Sol và 28,7% ở GPT-6 Luna, chỉ đứng sau Astra (1,5%). Bên cạnh đó, ghi nhận cho thấy mô hình không cố tình vượt qua bộ đánh giá an toàn tự động, tương tự như Astra và Sol. Dù vậy, do các bài kiểm tra này được thiết kế để kích thích kịch bản lỗi, kết quả thu được không phản ánh hoàn toàn trải nghiệm sử dụng thực tế.
Về khả năng tiếp cận, mô hình đã sẵn sàng từ ngày 29/09 cho toàn bộ người dùng các gói Plus, Pro, Business, Enterprise và Edu trên ChatGPT Work cũng như Codex, đồng thời phát hành qua API dưới định danh gpt-6.1-sol. Hiện tại, ChatGPT phiên bản tiêu chuẩn vẫn chưa hỗ trợ mô hình này. Trong vài ngày tới, OpenAI dự kiến triển khai thêm tùy chọn tốc độ Ultrafast trên Codex, cung cấp hiệu suất xử lý nhanh gấp tới 8 lần so với chuẩn ban đầu.
Nhìn rộng hơn, đây không chỉ là câu chuyện về nâng cấp mô hình. Chỉ mới một tuần trước, sự xuất hiện của GPT-6 Sol đã đánh dấu mức giảm giá 50% so với GPT-5.6 Sol. Việc tiếp tục hạ chi phí trong thời gian ngắn như vậy cho thấy giá đọc bộ nhớ đệm đang trở thành yếu tố cạnh tranh then chốt, thay thế cho các cuộc đua điểm số benchmark. Vấn đề cốt lõi còn lại là liệu việc thay thế mô hình chỉ sau bảy ngày có thực sự tối ưu hóa chi phí vận hành, hay sẽ khiến việc lựa chọn mô hình trở nên phức tạp hơn.