Vào đầu năm 2026, các nhân viên tại tập đoàn Meta đã cùng nhau đốt hơn 60 nghìn tỷ token chỉ trong vỏn vẹn 30 ngày, nhằm cạnh tranh thứ hạng trên một bảng xếp hạng nội bộ mang tên “Claudeonomics”. Theo ước tính của chuyên gia công nghệ Gergely Orosz, con số này tương đương với hóa đơn gần 900 triệu USD theo mức giá niêm yết công khai của Anthropic. Cùng thời điểm, hãng gọi xe Uber cũng tiêu sạch toàn bộ hạn mức ngân sách dành cho công cụ AI của cả năm 2026 chỉ sau bốn tháng hoạt động.
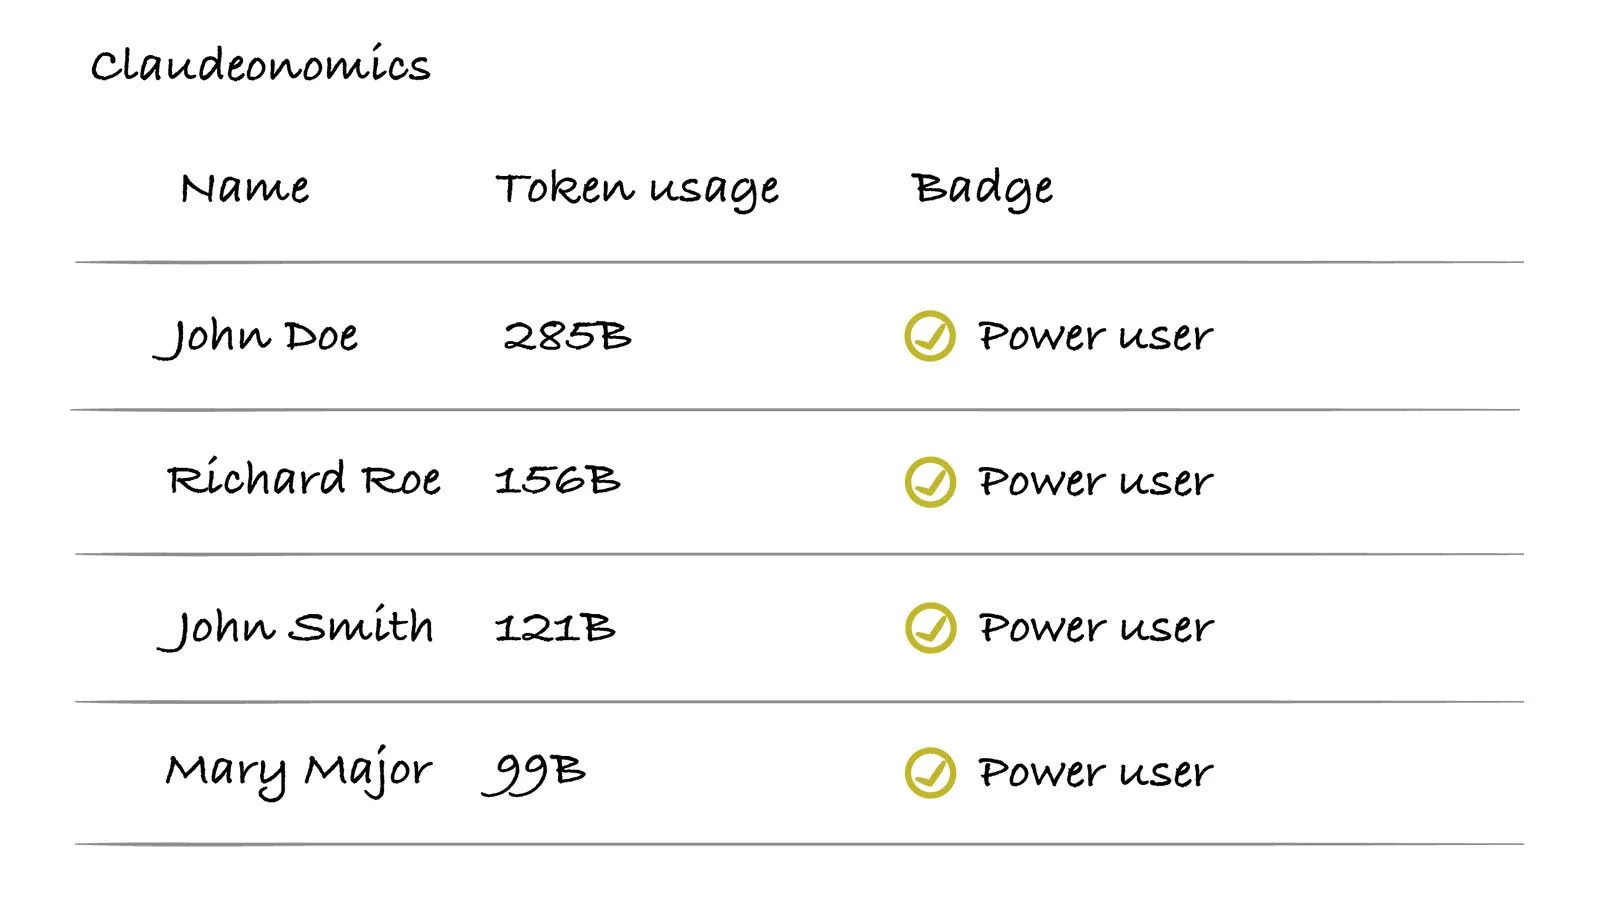
Hiện tượng này bắt nguồn từ một trào lưu được gọi là “tokenmaxxing”. Khi CEO Jensen Huang của Nvidia tuyên bố trên chương trình podcast All-In rằng ông sẽ vô cùng lo lắng nếu một kỹ sư nhận mức lương 500.000 USD không đốt ít nhất 250.000 USD tiền token mỗi năm, các doanh nghiệp công nghệ lớn đã nhanh chóng biến lượng tiêu thụ token thành một chỉ số đo lường hiệu suất làm việc. Kết quả là hàng triệu USD bị ném qua cửa sổ cho những tác vụ thừa thãi, chẳng hạn như dùng mô hình cao cấp nhất chỉ để tạo email hay kiểm tra ngữ pháp đơn giản.
Ngày nay, khái niệm tokenmaxxing đang được định hình lại theo đúng nghĩa thực dụng của nó: tối đa hóa giá trị mang lại trên từng token được sử dụng, thay vì thi đua đốt tài nguyên vô ích.
Hiểu đúng về vòng lặp và sự bùng nổ chi phí của tác nhân AI
Mỗi từ ngữ gửi đi hoặc nhận về từ các mô hình như Claude hay ChatGPT đều được tính toán theo token, tương đương khoảng ba phần tư của một từ tiếng Anh. Khoảng cách chi phí giữa các thế hệ mô hình hiện nay rất lớn: những mô hình suy luận hàng đầu có giá đầu vào cao gấp 100 lần so với các mô hình tinh gọn trong cùng một dòng sản phẩm.
Chi phí này càng nhân lên gấp bội khi người dùng chuyển từ giao diện hội thoại thông thường sang các tác nhân AI tự chủ (AI agents). Một agent khi được giao việc sẽ vận hành theo một vòng lặp liên tục: suy nghĩ, gọi công cụ duyệt web hoặc thực thi mã nguồn, đọc kết quả trả về, rồi quyết định bước tiếp theo. Ở mỗi vòng lặp, toàn bộ lịch sử trao đổi trước đó sẽ được gửi lại vào mô hình.
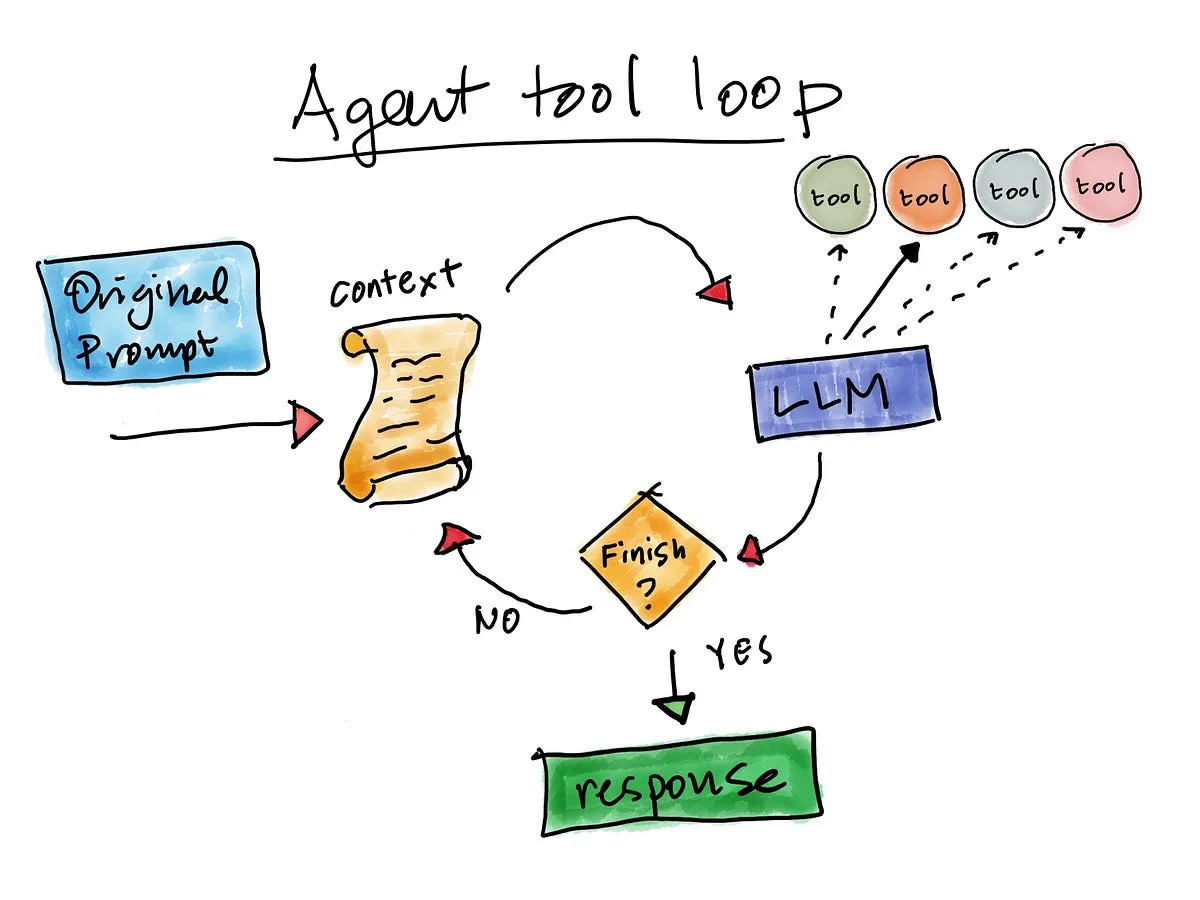
Nếu áp dụng thêm kiến trúc điều phối đa tác nhân (multi-agent orchestration), nơi một mô hình đóng vai trò quản lý phân chia công việc cho nhiều tác nhân phụ (subagents) chạy song song, số lượng token tiêu thụ có thể tăng vọt gấp bảy lần so với một phiên làm việc độc lập.
Các giải pháp cắt giảm chi phí theo từng cấp độ
Việc xây dựng kỷ luật sử dụng token không đòi hỏi những can thiệp kỹ thuật quá phức tạp, mà có thể bắt đầu ngay từ những thói quen căn bản.
Ở cấp độ người dùng phổ thông, nguyên tắc cốt lõi là chọn đúng công cụ cho từng tác vụ. Việc sử dụng những mô hình hàng đầu như Claude Opus, GPT Astra,… hay các biến thể Pro để tóm tắt văn bản hoặc viết lại đoạn văn ngắn chẳng khác nào thuê một giáo sư toán học chỉ để tính tiền thối tại quầy thanh toán.
Người dùng nên đặt mô hình tầm trung (Claude Sonnet, GPT Sol, …) làm mặc định và chỉ nâng cấp khi gặp phải những bài toán hóc búa cần suy luận logic nhiều bước. Ngoài ra, việc viết một câu lệnh (prompt) rõ ràng, chỉ rõ cấu trúc đầu ra mong muốn và chủ động mở phiên trao đổi mới khi đổi chủ đề sẽ giúp loại bỏ hiện tượng “thoái hóa ngữ cảnh” (context rot), nơi mô hình phải đọc lại những đoạn hội thoại cũ không liên quan.
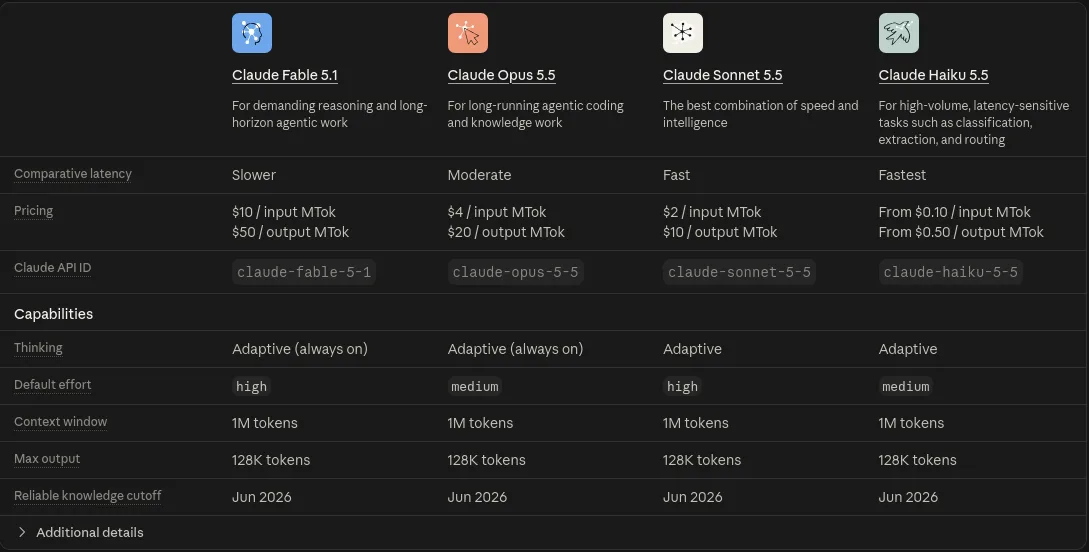
Đối với các nhóm phát triển và kỹ sư sử dụng công cụ lập trình dòng lệnh (coding agent) như Claude Code, Codex,… chiến lược “bắt đầu giá rẻ, chỉ nâng cấp khi gặp lỗi” mang lại hiệu quả kinh tế rõ rệt. Hãy để mô hình nhẹ xử lý trước và chỉ tự động kích hoạt mô hình lớn nếu bước thực hiện thất bại sau hai lần thử.
Đặc biệt, việc cắt tỉa danh sách công cụ mở rộng (MCP servers) giúp tiết kiệm đáng kể dung lượng bộ nhớ. Một thử nghiệm của Anthropic từng cho thấy lượng tiêu thụ token của tác nhân giảm từ 150.000 token xuống còn 2.000 token khi chỉ nạp những định nghĩa công cụ thực sự cần thiết thay vì giữ toàn bộ plugin luôn bật. Bên cạnh đó, việc giữ các tệp quy chuẩn dự án như CLAUDE.md dưới 200 dòng cũng giúp kiểm soát lượng dữ liệu đọc vào ở đầu mỗi phiên.
Ở cấp độ kiến trúc hệ thống, hai kỹ thuật mang lại mức tiết kiệm lớn nhất là bộ nhớ đệm (prompt caching) và xử lý theo lô (batch processing). Bằng cách đặt các khối chỉ dẫn cố định lên phần đầu ngữ cảnh và bật cờ lưu trữ tạm thời, các lệnh gọi sau chỉ tốn một phần nhỏ chi phí so với việc nạp mới hoàn toàn. Song song đó, các tác vụ không đòi hỏi phản hồi tức thì có thể được đóng gói để gửi qua giao diện xử lý lô, giúp cắt giảm ngay 50% chi phí hóa đơn. Các kỹ sư cũng nên thiết lập hạn mức ngân sách cứng cho từng phiên làm việc để ngăn chặn nguy cơ tác nhân bị rơi vào vòng lặp vô tận.
Nghịch lý Jevons trong kỷ nguyên trí tuệ nhân tạo
Theo chỉ số chi tiêu token của Silicon Data, giá trung bình của một token đã giảm hơn 90% kể từ năm 2023. Tuy nhiên, nghịch lý là tổng ngân sách mà các công ty chi trả cho các nhà cung cấp mô hình lại tăng gấp đôi trong cùng khoảng thời gian.
Các nhà kinh tế học gọi đây là nghịch lý Jevons: khi một nguồn tài nguyên trở nên rẻ hơn và dễ tiếp cận hơn, nhu cầu sử dụng thực tế sẽ bùng nổ đến mức tổng lượng tiêu thụ cuối cùng tăng vọt. Một báo cáo của Bain & Company vào tháng 06/2026 cũng ghi nhận thực tế tương tự khi chi phí token giảm một nửa nhưng số lượng token tiêu thụ lại tăng tới 450%.
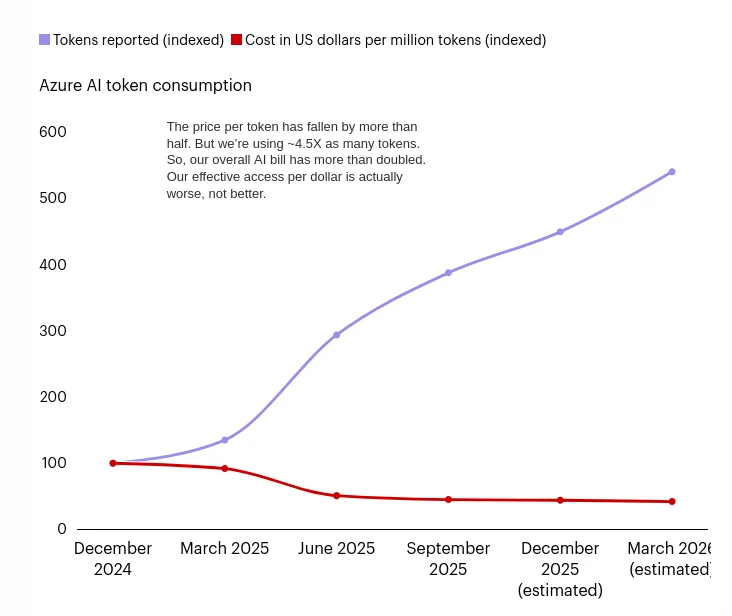
Việc giá suy luận giảm xuống mở ra cơ hội to lớn cho việc tự động hóa, nhưng cũng đồng thời tạo ra ảo giác rằng tài nguyên tính toán là vô hạn. Những cá nhân và tổ chức nắm vững kỹ năng quản trị token sẽ là những người tạo ra nhiều giá trị nhất: họ vừa tận dụng được sức mạnh ngày càng lớn của các mô hình mới, vừa không bị cuốn vào vòng xoáy chi phí vô nghĩa mà các chiến dịch tiếp thị đang cố gắng thúc đẩy.