Xiaomi, công ty công nghệ Trung Quốc, vừa công bố MiMo-V2.6, series model AI mới gồm hai phiên bản Pro và Flash. Phiên bản Pro có 1,02 nghìn tỷ tham số, hỗ trợ context window 1 triệu token, và là model omnimodal (xử lý đồng thời text, hình ảnh và các loại dữ liệu khác).
Về thông số, Mimo-V2.6 Pro và Flash đều vượt trội hơn rất nhiều so với đời V2.5 nhờ vào việc được huấn luyện bằng reinforcement learning ở quy mô lớn, đồng thời được tăng cường thêm khả năng lập trình, sử dụng máy tính, suy luận 3D và sáng tạo. Một số đánh giá cụ thể từ MiMo và trang Artificial Analysis:
-
Trên Artificial Analysis Intelligence Index, MiMo V2.6 Pro đạt 46.32, gần gấp đôi so với V2.5 Pro (26 điểm) và là model open-source có điểm số cao nhất, vượt mặt Kimi K3 và Qwen3.8 Max.
-
So với Claude Opus 5 và GPT-5.6 Sol , V2.6 Pro hoạt động ngang bằng với trên hầu hết các agent benchmarks.
-
Model V2.6 Flash cũng vượt mặt V2.5 Pro về mọi mặt và chỉ kém bản Pro ở một vài task khó (Terminal Bench 4.0, exploit/cyber, Agents’ Last Exam)
Về giá, cả 2 phiên bản MiMo V2.6 đều có giá cực kỳ rẻ, cụ thể:
-
V2.6 Flash: 0.14 USD/M token input, 0.28 USD/M token output
-
V2.6 Pro: 0.435USD/M token input, 0.87 USD/M token output
- V2.6 Pro UltraSpeed: Nhanh hơn 20 lần Pro, 4.35 USD/M token input, 8.7 USD/M token output
Đặc biệt, đội ngũ đang livestream công khai quá trình trên trang mimo.xiaomi.com, một động thái hiếm gặp từ bất kỳ lab AI nào.
Sáu tháng im lặng để nghiên cứu một câu hỏi
Fuli Luo, người dẫn đầu đội ngũ MiMo của Xiaomi và trước đó từng làm việc tại DeepSeek, thông báo trên X rằng đội ngũ đã trải qua “gần nửa năm im lặng” để nghiên cứu một câu hỏi cụ thể: reinforcement learning có thể scale đến đâu? Câu trả lời là MiMo-V2.6, không chỉ là một model mới mà là kết quả của một cuộc đặt cược nghiên cứu dài hạn vào RL như đòn bẩy chính để cải thiện model, thay vì chỉ tiếp tục tăng cường compute cho pretraining.
Quan điểm này phù hợp với xu hướng rộng hơn trong ngành: lợi nhuận biên của pretraining đang giảm, và các lab đang chuyển trọng tâm sang post-training, đặc biệt là RL trên các tác vụ agent. Luo tuyên bố: “RL là một trong những con đường có thể mở rộng quy mô và hiệu quả nhất hướng tới tự cải tiến.”
Ba trục scaling: compute, môi trường, grader
Nhóm phát triển MiMo đã chia sẻ chi tiết về ba trục mở rộng (scaling) chính cùng các thông số cụ thể:
-
Compute quy mô lớn: Vận hành hoàn toàn bất đồng bộ với 1.568 prompt và 16 rollout cho mỗi prompt, xử lý khoảng 2 tỷ token trong mỗi bước huấn luyện.
-
Môi trường & harness đa dạng: Áp dụng RL đa tác vụ cho agent (multi-task agentic RL), kết hợp đồng thời nhiều harness trong cùng một đợt training thay vì thực hiện riêng lẻ rồi mới hợp nhất.
-
Grader compute chuyên sâu: Sử dụng cơ chế phân bổ tín hiệu phần thưởng nhóm (agentic in-group credit assignment), tổng hợp đánh giá từ test-case lẫn rubric và tận dụng năng lực tính toán suy luận để đo lường chất lượng của từng rollout.
Đáng chú ý, Grader compute chính là trụ cột được MiMo đầu tư chuyên sâu nhất. Trong khi phần lớn các thảo luận về RL scaling hiện nay chỉ xoay quanh hai yếu tố đầu tiên (năng lực tính toán cho rollout và tính đa dạng của môi trường), việc MiMo tách riêng và nâng tầm grader compute thành một trục mở rộng độc lập cho thấy chất lượng của tín hiệu phần thưởng chính là rào cản cốt lõi cần giải quyết, chứ không đơn thuần là một khâu kỹ thuật phụ trợ.
Chi phí training 493.000 USD mỗi ngày, livestream công khai
Theo ước tính từ các nguồn theo dõi quá trình training, chi phí chạy RL ở quy mô này khoảng 493.000 USD mỗi ngày. Đây là con số cụ thể và hiếm hoi về chi phí thực tế của việc train model nghìn tỷ tham số với RL nặng về agentic environment.
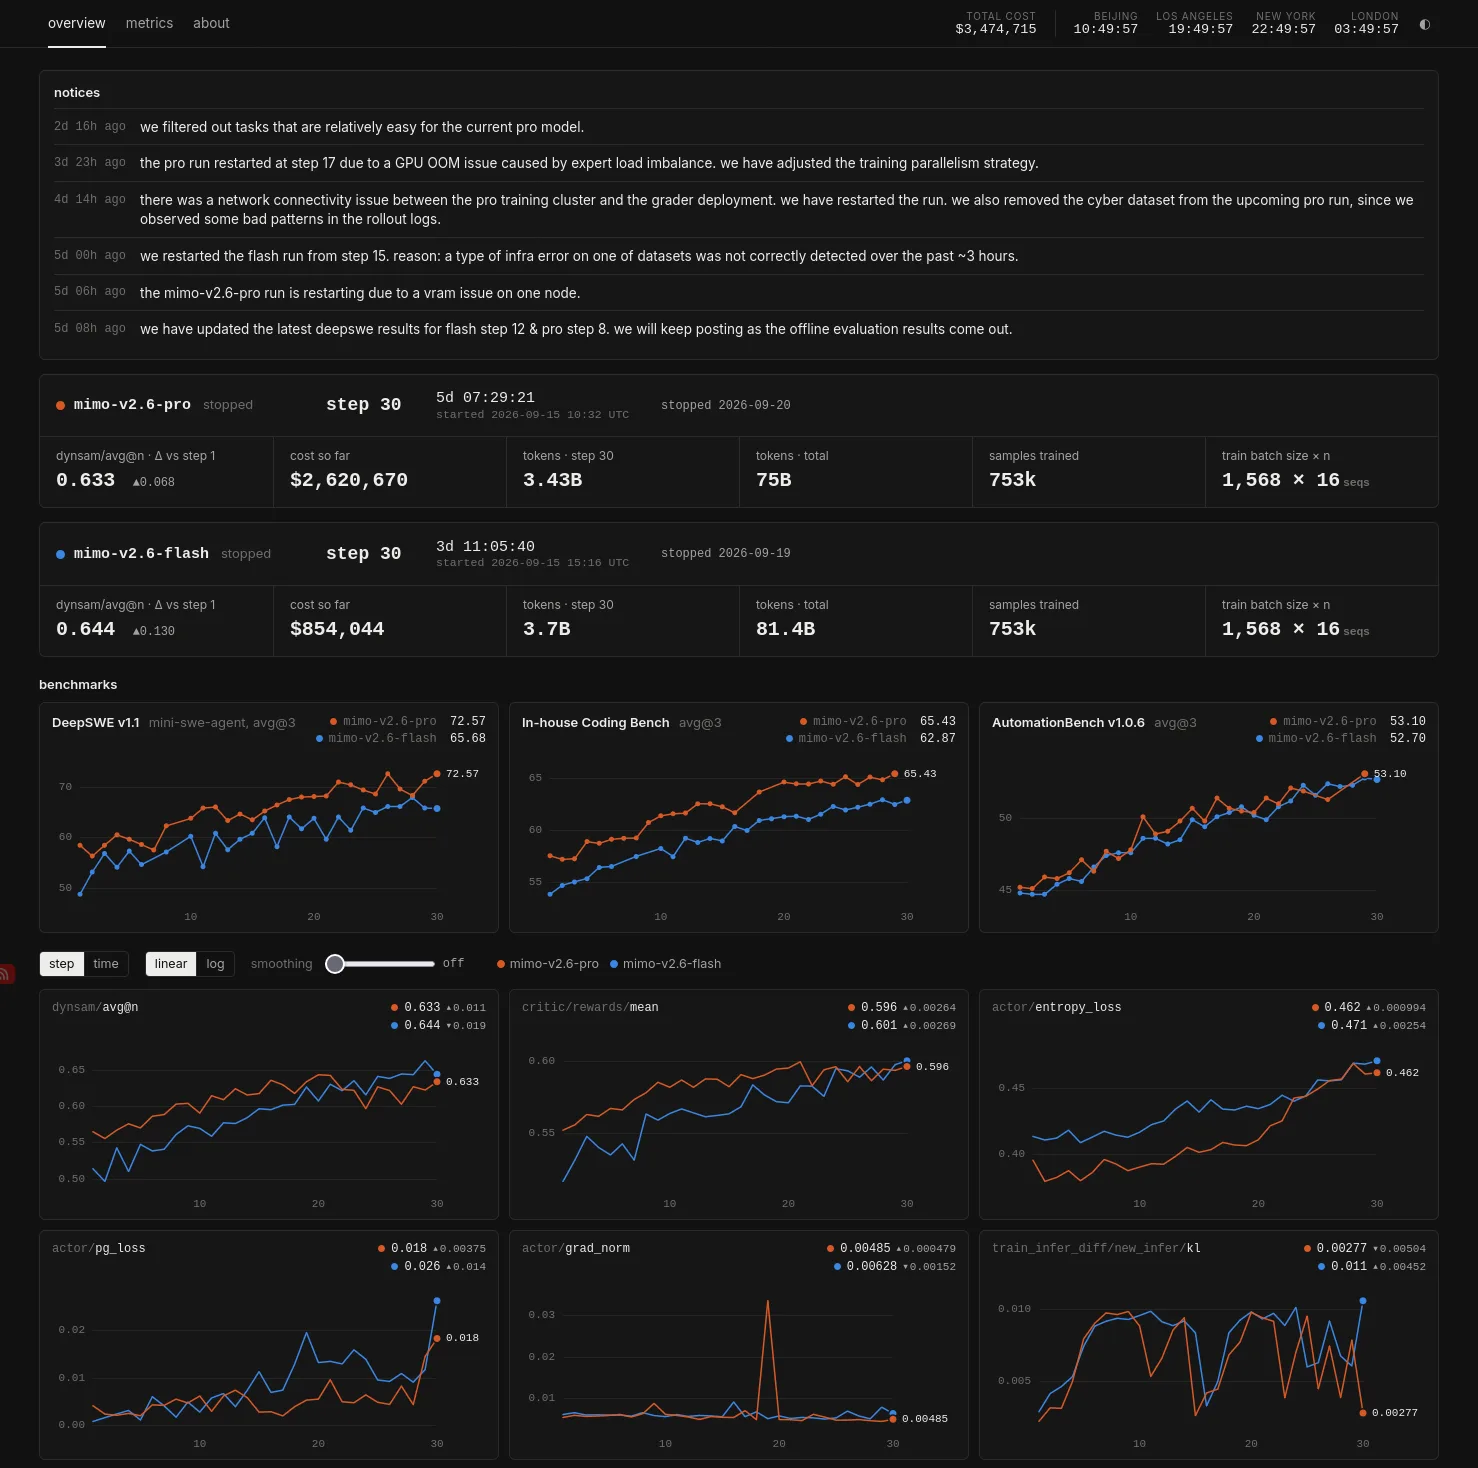
Việc livestream quá trình training là động thái hiếm gặp. Các lab lớn như OpenAI, Anthropic, Google DeepMind thường chỉ công bố kết quả sau khi hoàn thành, không công khai quá trình đang chạy. Luo cam kết sẽ mở nguồn chi tiết phương pháp “từng phần trong những tuần tới”, thay vì một báo cáo kỹ thuật duy nhất.
Chưa phải model hoàn chỉnh
Model MiMo-V2.6 hiện vẫn chưa hoàn thiện và đang trong giai đoạn huấn luyện. Do đó, kết quả benchmark chính thức vẫn chưa được công bố. Những thông số hiện tại trên HokAI hay Artificial Analysis thực chất là của phiên bản Pro đã ra mắt trước đó, chứ không phản ánh kết quả sau cùng của tiến trình RL hiện tại.
Bên cạnh đó, nhóm phát triển vẫn giữ yên lặng trước thắc mắc từ cộng đồng kỹ thuật. Cụ thể, một kỹ sư đã nghi ngờ tính “fully async” khi cho rằng tổng thời gian bước vẫn bằng thời gian trainer cộng sampler, tức là các thành phần vẫn phụ thuộc tuần tự vào nhau.
Dù việc phát trực tiếp quá trình huấn luyện mô hình nghìn tỷ tham số là chiêu trò truyền thông hay sự minh bạch thực sự, MiMo-V2.6 vẫn cho thấy cam kết mạnh mẽ của Xiaomi đối với lĩnh vực AI tiên phong—không chỉ dừng lại ở quy mô năng lực tính toán mà còn ở tinh thần cởi mở chưa từng có đối với một doanh nghiệp công nghệ tiêu dùng.