Vào ngày 06/10, Mistral đã chính thức công bố bản xem trước công khai cho Mistral Large 4 (được gọi vui là Le Chonk). Mẫu mô hình lớn nhất từ trước đến nay của công ty sở hữu kiến trúc mixture-of-experts với tổng cộng 1.000 tỷ tham số và 52 tỷ tham số kích hoạt trên mỗi token. Mô hình hỗ trợ đầu vào đa phương thức và được huấn luyện hoàn toàn từ đầu trên hệ thống 3.800 GPU NVIDIA Grace Blackwell thuộc các trung tâm dữ liệu của Mistral tại châu Âu.
Hiện tại, người dùng chỉ có thể trải nghiệm mô hình qua API hoặc giao diện Le Chat. Trọng số của mô hình vẫn chưa được công bố công khai do Mistral đang tiến hành kiểm tra an ninh (red-teaming) thực tế cùng các cơ quan nhà nước và đối tác bảo mật; dự kiến trọng số sẽ được phát hành vào cuối tháng này.
Chi phí dịch vụ và lợi thế cạnh tranh
Mức giá chính thức
Về chi phí, Mistral đưa ra mức giá 1,36 USD/triệu token đầu vào và 4,18 USD/triệu token đầu ra. Dù cao hơn các mô hình quy mô nhỏ, mức định giá này vẫn rất cạnh tranh và kinh tế hơn đáng kể so với các dòng mô hình hàng đầu (frontier) của OpenAI hay Anthropic.
Đánh giá từ MindStudio cho thấy hiệu quả chi phí vận hành có được là nhờ kiến trúc tối ưu: việc giới hạn tối đa 52 tỷ tham số kích hoạt cho mỗi token giúp tiết kiệm đáng kể chi phí suy luận so với các mô hình dạng dày (dense) có cùng kích thước. Nhờ đó, Mistral vừa bảo đảm quy mô tham số ấn tượng, vừa duy trì mức chi phí vận hành cực kỳ hợp lý.
Mức độ an toàn
Song song với ưu thế về giá, an toàn thông tin cũng được xem là một trụ cột cốt lõi. Theo Bảng xếp hạng Cyber từ Artificial Analysis, Mistral Large 4 thuộc top 5 công cụ hàng đầu thế giới về phát hiện và khắc phục lỗi phần mềm, đồng thời dẫn đầu trong nhóm các mô hình trọng số mở phát triển ngoài Trung Quốc. Trong các bài kiểm tra thực tế về tái hiện và vá lỗ hổng mã nguồn mở, mô hình đạt tỷ lệ thành công 82%, mức cao nhất được công bố, cùng khả năng vượt qua 93% bài đánh giá trên Cybench.
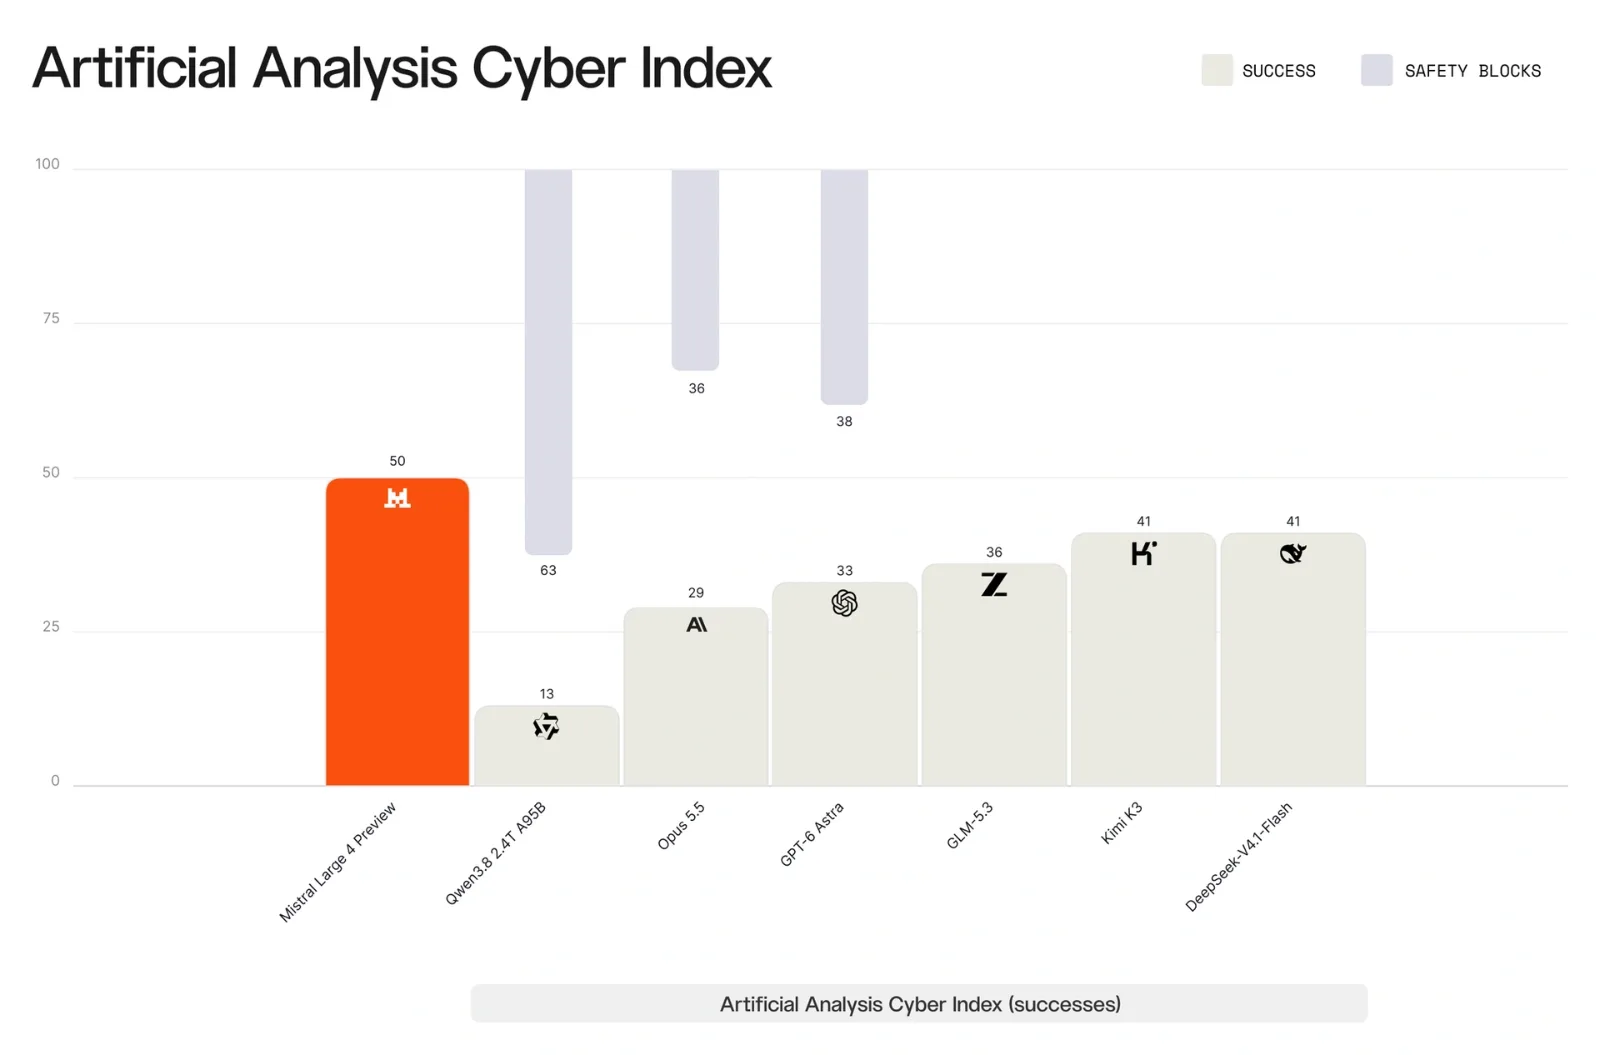
Một khía cạnh đáng lưu ý trong lập luận từ phía Mistral là việc họ cho rằng một số mô hình hàng đầu (tiêu biểu như Claude Opus 5.5 và GPT-6 Astra) gần như ghi nhận điểm số 0% trong cùng bài thử nghiệm do thẳng thừng từ chối thực hiện yêu cầu. Dù kết quả so sánh này cần được tiếp cận một cách khách quan do xuất phát từ nhận định và số liệu nội bộ của Mistral, nó đã làm nổi bật một hạn chế thực tế: các cơ chế kiểm duyệt an toàn khắt khe của mô hình đóng đôi khi vô tình gây cản trở chính công tác phòng thủ, vốn đòi hỏi bước khởi đầu là mô phỏng và chứng minh sự tồn tại của lỗ hổng bảo mật.
Hiệu suất lập trình và khả năng thực thi tác vụ agent
Ở khía cạnh lập trình, số liệu do Mistral công bố ghi nhận mô hình đạt 61,7% trên DeepSWE v1.1, 59,4% trên SWE-Atlas-QnA cùng 28,3% trên Terminal-Bench 4. Tính chung chỉ số Coding Agent Index, Mistral Large 4 vươn lên mốc 49,8%, xếp trên hai đối thủ Qwen3.8 Max và DeepSeek V4 Pro 0813.
Đối với thử nghiệm mù do Surge AI thực hiện, nơi chuyên gia chấm điểm không được biết danh tính mô hình tạo ra kết quả, Mistral Large 4 giành vị trí thứ hai trong số năm mô hình tham gia với 3,74 điểm. Mức điểm này vượt qua Kimi K3 lẫn hai phiên bản của GLM, chỉ xếp sau Claude Opus 5 (4,22 điểm).
Song song đó, kết quả kiểm thử độc lập từ MindStudio cũng ghi nhận nhiều tín hiệu tương đồng với bảng điểm công bố:
-
Phát hiện lỗ hổng IDOR: Mô hình nhận diện thành công lỗi IDOR thử nghiệm trong ứng dụng Flask và chỉ ra nguyên nhân gốc rễ do endpoint xóa có phân quyền nhưng endpoint đọc lại bỏ ngỏ.
-
Bảo mật mã nguồn: Tiếp tục phát hiện thêm mật khẩu lưu trữ dưới dạng plain text và một khóa phiên (session key) bị chèn cứng trực tiếp trong mã nguồn.
Hạn chế hiện tại và các yếu tố cần theo dõi
Bên cạnh những ưu điểm, MindStudio cũng chỉ ra các nhược điểm còn tồn tại của mô hình:
-
Tác vụ dòng lệnh & quy trình doanh nghiệp: GLM 5.3 của Trung Quốc vẫn duy trì thế dẫn trước ở nhóm tác vụ xử lý dòng lệnh và quy trình liên ứng dụng.
-
Khả năng dịch thuật: Mistral Large 4 hoạt động tốt với các ngôn ngữ phổ biến (tiếng Trung, tiếng Ả Rập, tiếng Nhật, tiếng Thái), nhưng chất lượng suy giảm đáng kể đối với ngôn ngữ hiếm dữ liệu như tiếng Gujarat.
-
Tái tạo hình ảnh: Trong thử nghiệm mô phỏng, hình ảnh chi tiết như ngọn lửa trong cảnh quay chưa đạt độ sinh động bằng bản gốc.
Để đánh giá chính xác, thông tin cần được phân tách thành ba góc độ:
-
Thực tế đã ghi nhận: Mistral công bố bản xem trước vào ngày 06/10, sử dụng hạ tầng châu Âu để huấn luyện, đồng thời niêm yết giá dịch vụ và cam kết mở trọng số ngay trong tháng.
-
Góc nhìn phân tích: Việc một mô hình mở trọng số đạt kết quả cao về bảo mật mang lại lợi thế lớn cho các tổ chức có nhu cầu tự triển khai hệ thống.
-
Yếu tố chưa kiểm chứng: Phần lớn số liệu kiểm định xuất phát từ chính Mistral hoặc thông qua bảng điểm bên thứ ba nhưng chưa trải qua quy trình xác minh độc lập toàn diện.
Nguồn vốn từ vòng Series D trị giá 3 tỷ euro, quy mô kỷ lục đối với một doanh nghiệp công nghệ châu Âu, đang được Mistral tập trung đầu tư nhằm nâng cấp hạ tầng tính toán. Dù vậy, câu hỏi lớn nhất vẫn còn ở phía trước: liệu cộng đồng công nghệ có thể tái lập các kết quả bảo mật ấn tượng này khi trọng số chính thức được phát hành vào cuối tháng, hay bản phát hành thực tế sẽ mang lại kết quả khác biệt so với bản xem trước?